NLP / INGENIERÍA DE DATOS · Diciembre 2025 – enero 2026
NLP PipelineDel ruido al significado.
Extracción y traducción multi-modelo de contenido web, con procesamiento por lotes y control de consistencia.
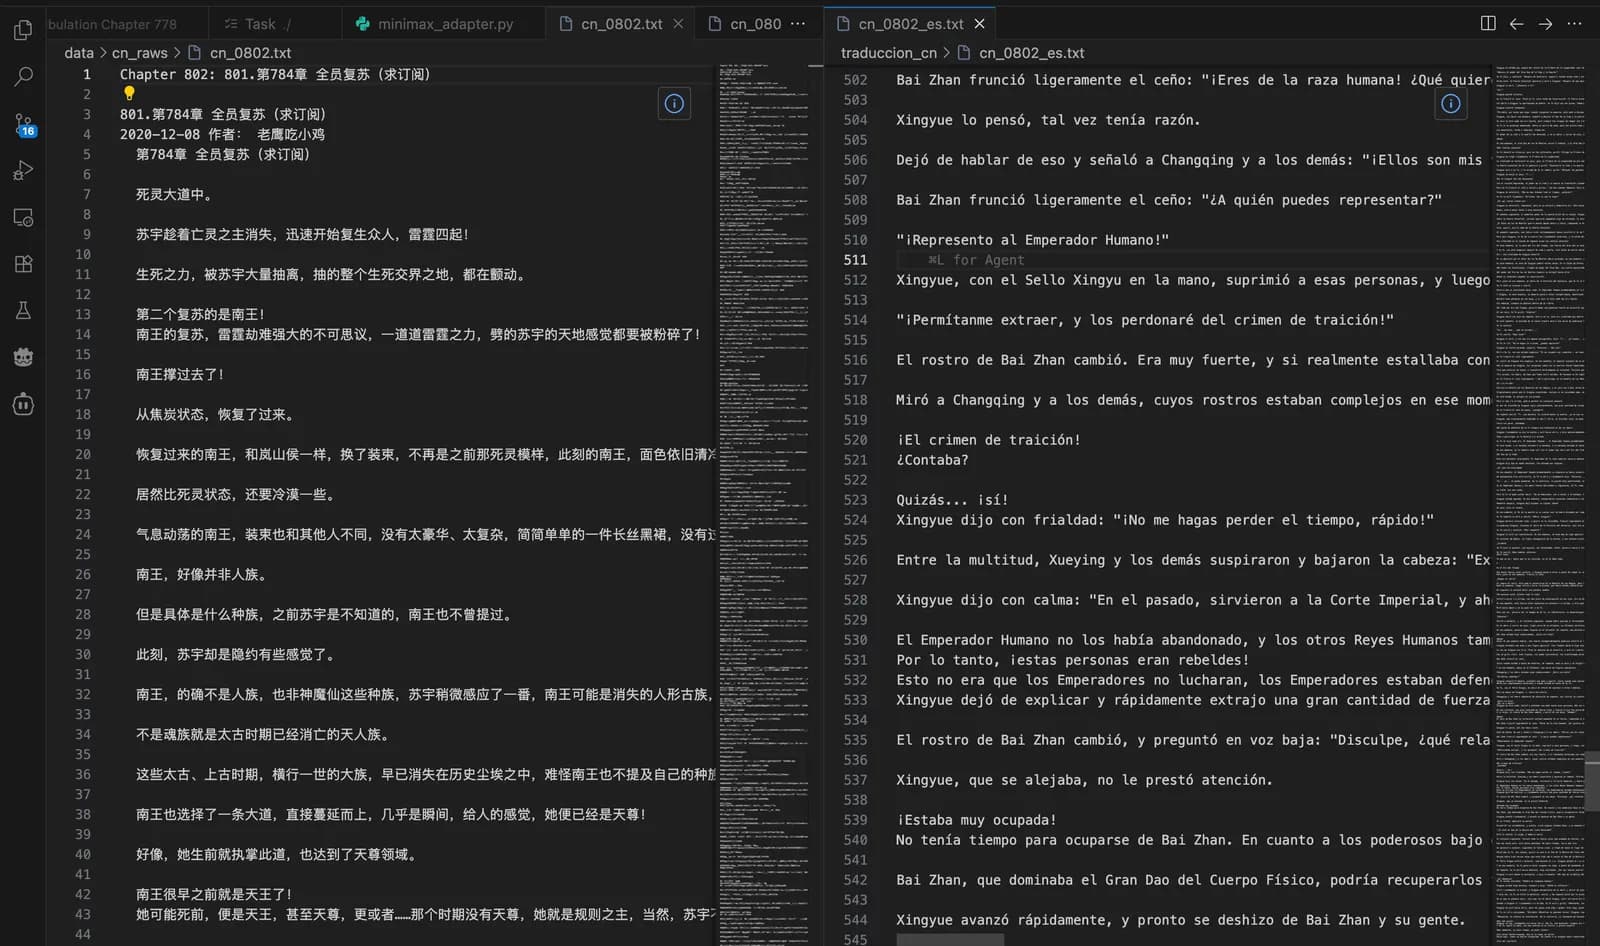
EVIDENCIA VERIFICABLE · OCTUBRE 2026
- Código fuente
- GitHub · Python ↗
El problema
Extraer, ordenar y traducir contenido web manualmente introduce inconsistencias y trabajo repetitivo.
Mi aportación
Construcción del pipeline end-to-end y adaptadores de modelos, con normalización y post-procesamiento del texto.
Cómo funciona
- Contenido web
- Extracción
- Traducción
- Texto estructurado
Proyecto personal
Pipeline para extraer, normalizar, traducir y formatear texto multilingüe mediante procesamiento por lotes y orquestación de modelos LLM.
La demostración interactiva recorre una frase preparada; no consulta sitios externos ni ejecuta una traducción en vivo.
Decisiones de diseño
- Normalizar el contenido antes de procesarlo con diferentes modelos.
- Mantener consistencia en contenido extenso y separar las etapas de procesamiento.
Puedo construir algo así para ti
Automatización de procesos e integraciones
Conecta tus herramientas y elimina tareas repetitivas: reportes, capturas y avisos automáticos.
Ver servicio →Chatbots e inteligencia artificial aplicada
Asistentes y flujos con IA que responden, clasifican y extraen datos, con revisión humana.
Ver servicio →Extracción de datos y scraping web
Recolecta información pública de la web de forma ordenada: precios, catálogos y listados.
Ver servicio →¿Tienes un problema parecido?
Podemos conversar sobre tu operación, definir el alcance y encontrar un punto de partida.
Cuéntame tu idea ↗